云与资本开支
当前共 75 条相关资讯
在 AWS 上构建超低延迟的语音 AI 应用
AWS 博客介绍 Cartesia 用 SSM 在云上实现百毫秒内语音。
谷歌宁愿少卖云算力,也要优先保障 Gemini:皮查伊罕见长访谈披露 AI 自我改进与算力争夺内幕
皮查伊长访谈:谷歌优先把算力留给 Gemini,而非对外售卖云算力

Arm 生态十月盘点:端侧 AI、云基础设施与物理 AI 的进展
Arm 汇总十月生态:433 核自动驾驶车、触觉假肢、AI 眼镜
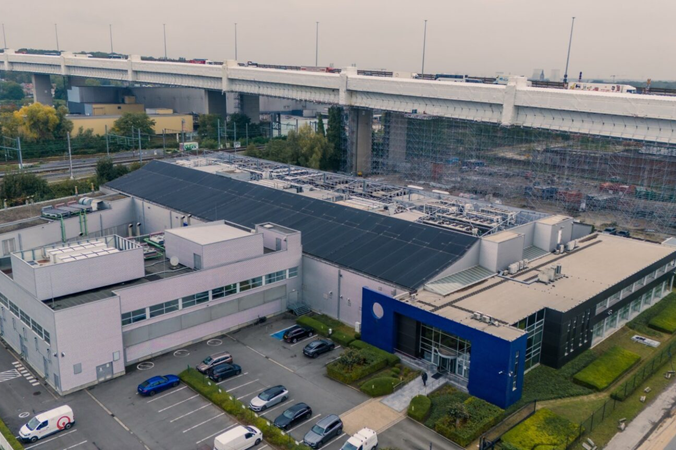
Nebul 在比利时 Datacenter United 园区部署英伟达 GPU
Nebul在比利时部署英伟达GPU,提供AI云租赁容量
当 AI 从“会想”走向“会干”:腾讯云与英特尔共筑 Agentic AI 执行底座
腾讯云与英特尔联合发布面向智能体执行的底座方案
OneQode 在印度向 AdaniConneX 租赁 14MW 数据中心容量
AI 云公司 OneQode 租用印度 14MW 容量,系其首个印度部署
AWS Batch 推出配额管理:SageMaker 训练任务可在团队间借还 GPU 算力
AWS Batch 新增配额共享与借贷调度,缓解多团队争抢 GPU
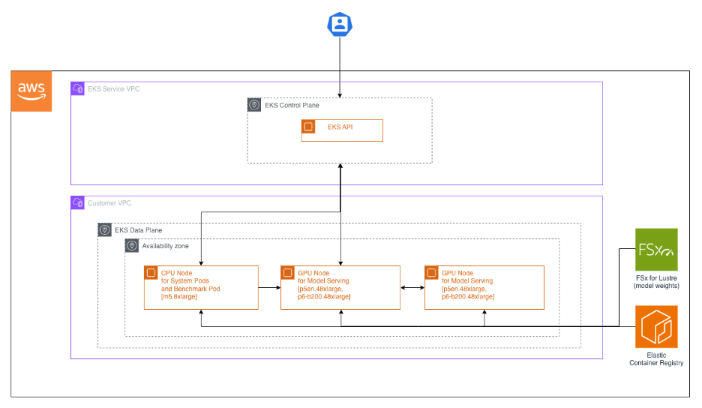
在 Amazon EKS 与 SageMaker HyperPod 上部署 NVIDIA Nemotron 模型,加速智能体 AI
AWS 博客详解 Nemotron 3.5 Super VL 及在 EKS 上的部署路径
微软公布 2027 财年第一季度财报:营收 923 亿美元同比增长 19%,Azure 增长 48%
微软第一财季营收 923 亿美元增 19%,Azure 增 48%
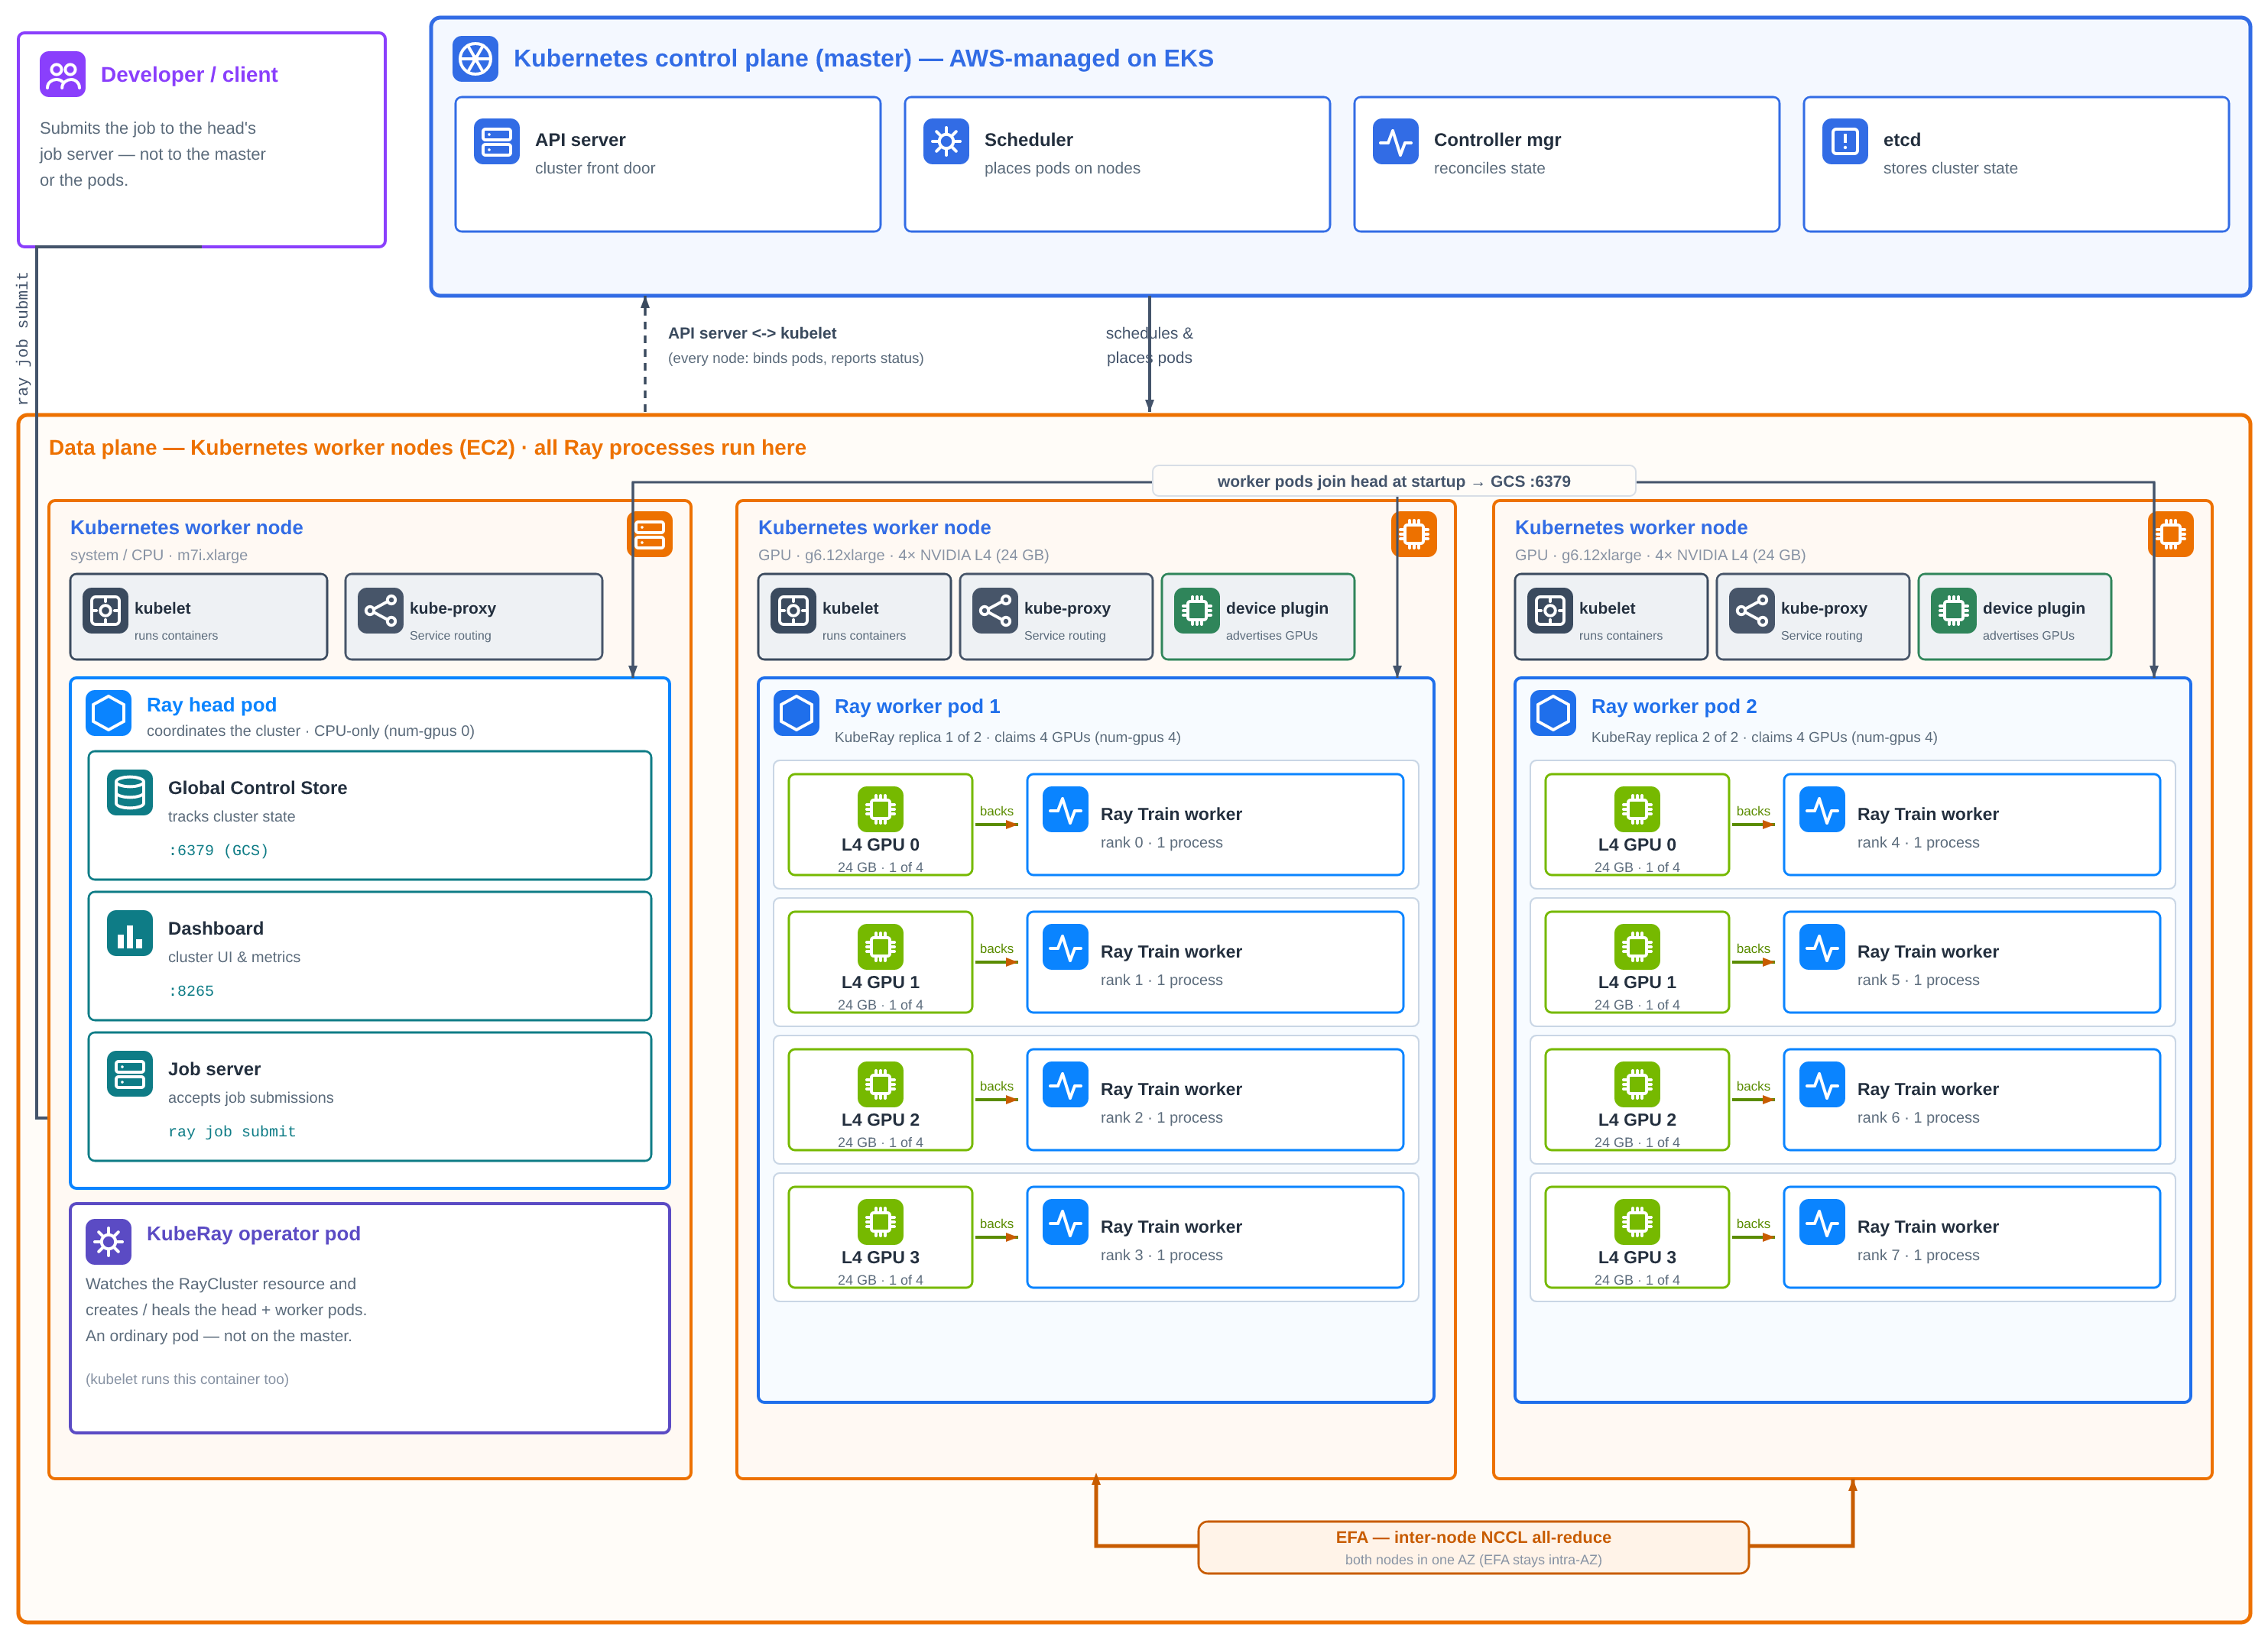
在 EKS 上用 Ray Train DLC 与 EFA 做分布式训练
AWS 用预构建容器省去自建分布式训练镜像

英伟达 Vera Rubin 与 Vera CPU 在 Oracle 云正式可用
英伟达新一代 Vera Rubin 平台与 Vera CPU 在 OCI 上正式可用
Oracle将通过OCI提供谷歌TPU AI芯片
甲骨文成首个在谷歌之外提供TPU的超大规模云厂商
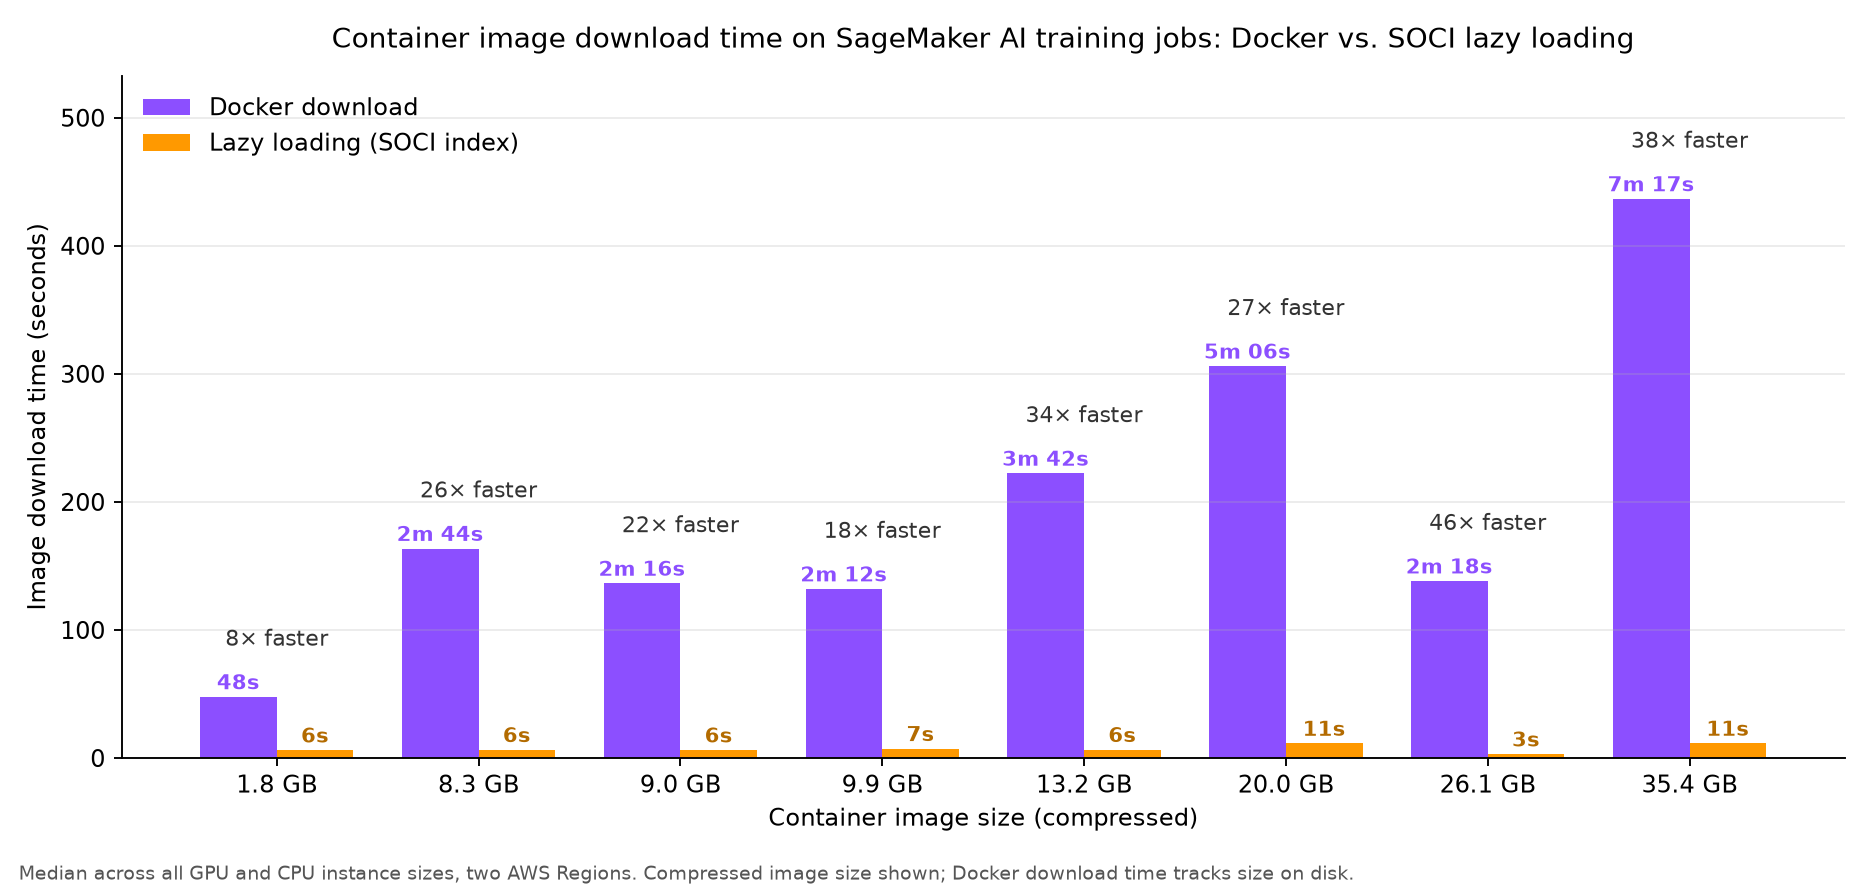
AWS 为 SageMaker AI 推出 SOCI 索引镜像,作业启动提速
SageMaker 训练与处理作业支持 SOCI 懒加载,镜像拉取不再拖慢启动
Arm 解读智能体 AI:从云端到边缘,计算范式将如何被改写
Arm 拆解智能体 AI 的四步循环及其对端云算力架构的重塑

中国近50%的新云生意,竟被这家公司包揽!
中国近半新增云生意被单一厂商包揽
格鲁吉亚 Silk Cloud 部署英伟达 Blackwell Ultra GPU
格鲁吉亚云商部署英伟达 Blackwell Ultra GPU
Aleria 将在美国与阿联酋部署英伟达 Blackwell 与 Vera Rubin GPU
新兴云厂商 Aleria 联合 DDN 部署英伟达新一代 GPU

你的模型能跑在 AWS Trainium 上吗?查一下就知道
Hugging Face 推出可查询模型对 AWS Trainium 支持情况的检索入口

报道称英伟达洽谈投资Firmus,后者IPO失败后寻求融资
英伟达或向新云Firmus投资数亿美元
OpenAI 聘请新的能源监管负责人
Will Friedman 从 AWS 加入,负责能源监管
英伟达 Vera Rubin 基础设施在谷歌云全面可用
英伟达 Vera Rubin 在谷歌云全面可用,下月起通过 A5X 实例提供
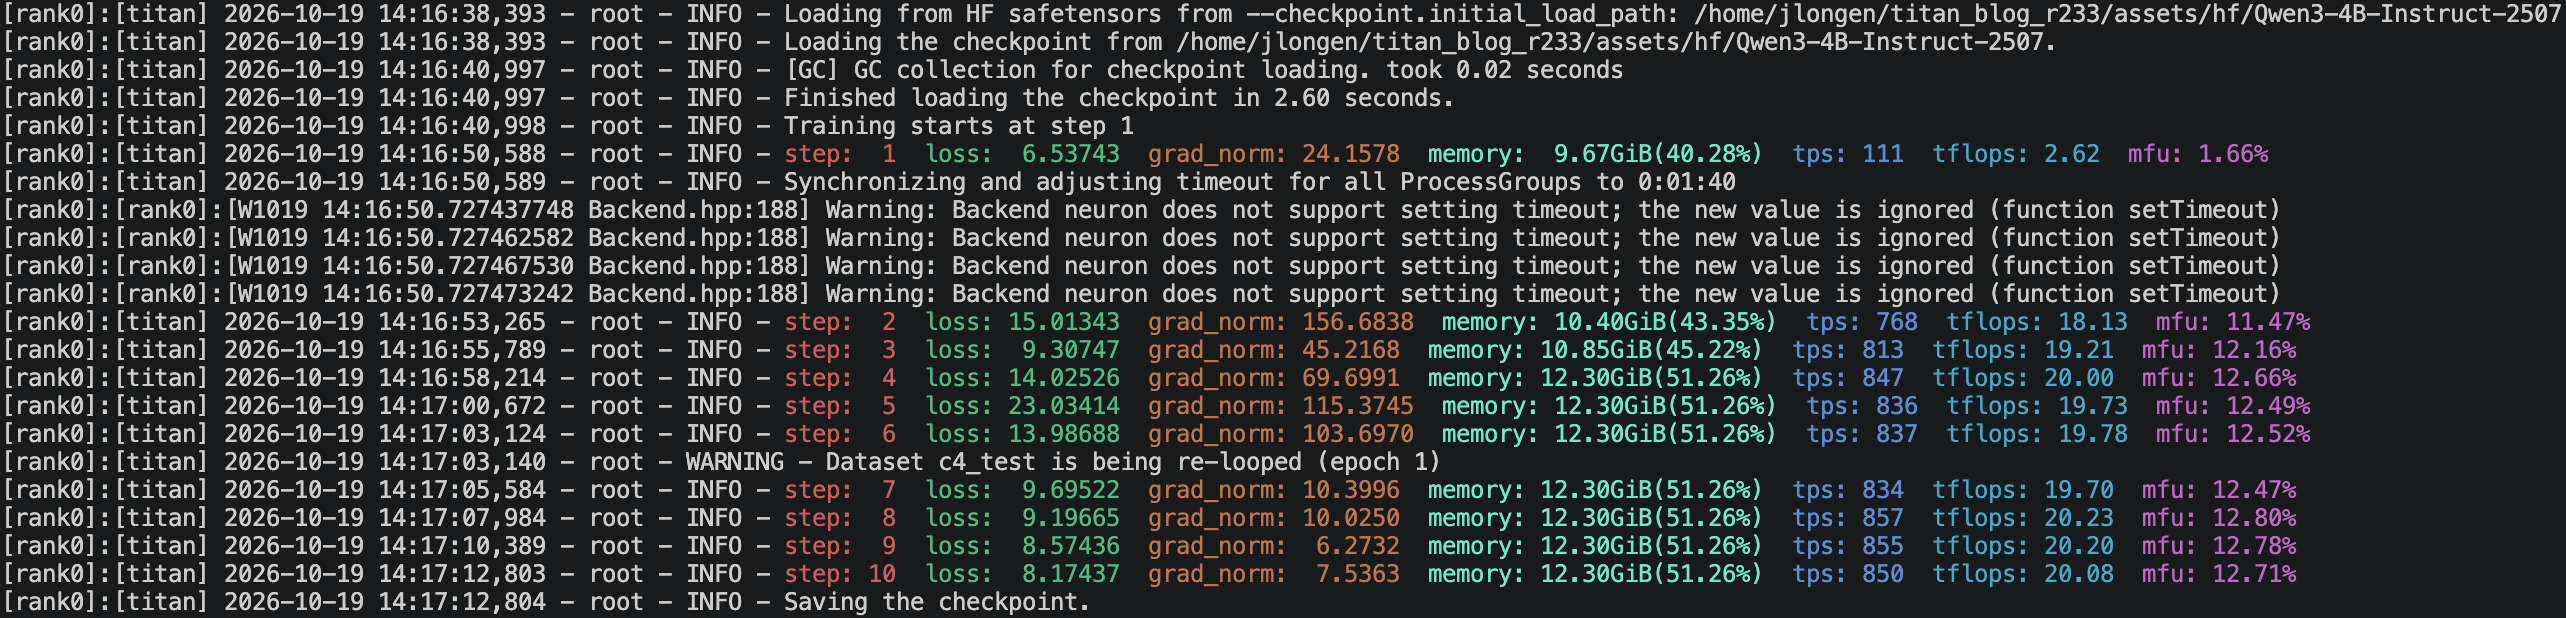
在 AWS Trainium 上用 torchtitan 训练 Qwen3
AWS 官方教程:在 Trainium 上用 torchtitan 训练 Qwen3 的三种配置方式
OpenAI 最新模型将登陆 Google Cloud 与 Antigravity
OpenAI 前沿模型将上架谷歌云 Model Garden 及其编程工具 Antigravity

剖析 TorchNeuron(第一部分):在 AWS Trainium 上进行系统级剖析
TorchNeuron 在 Trainium 上的系统级性能剖析
谷歌云与英伟达宣布 Vera Rubin 基础设施全面可用
谷歌云下月将上线基于 Vera Rubin 的 A5X 实例
英伟达云合作伙伴在欧洲扩张:主权、开放、面向安全 AI 智能体
英伟达云伙伴扩建欧洲主权 AI 算力并强化能效
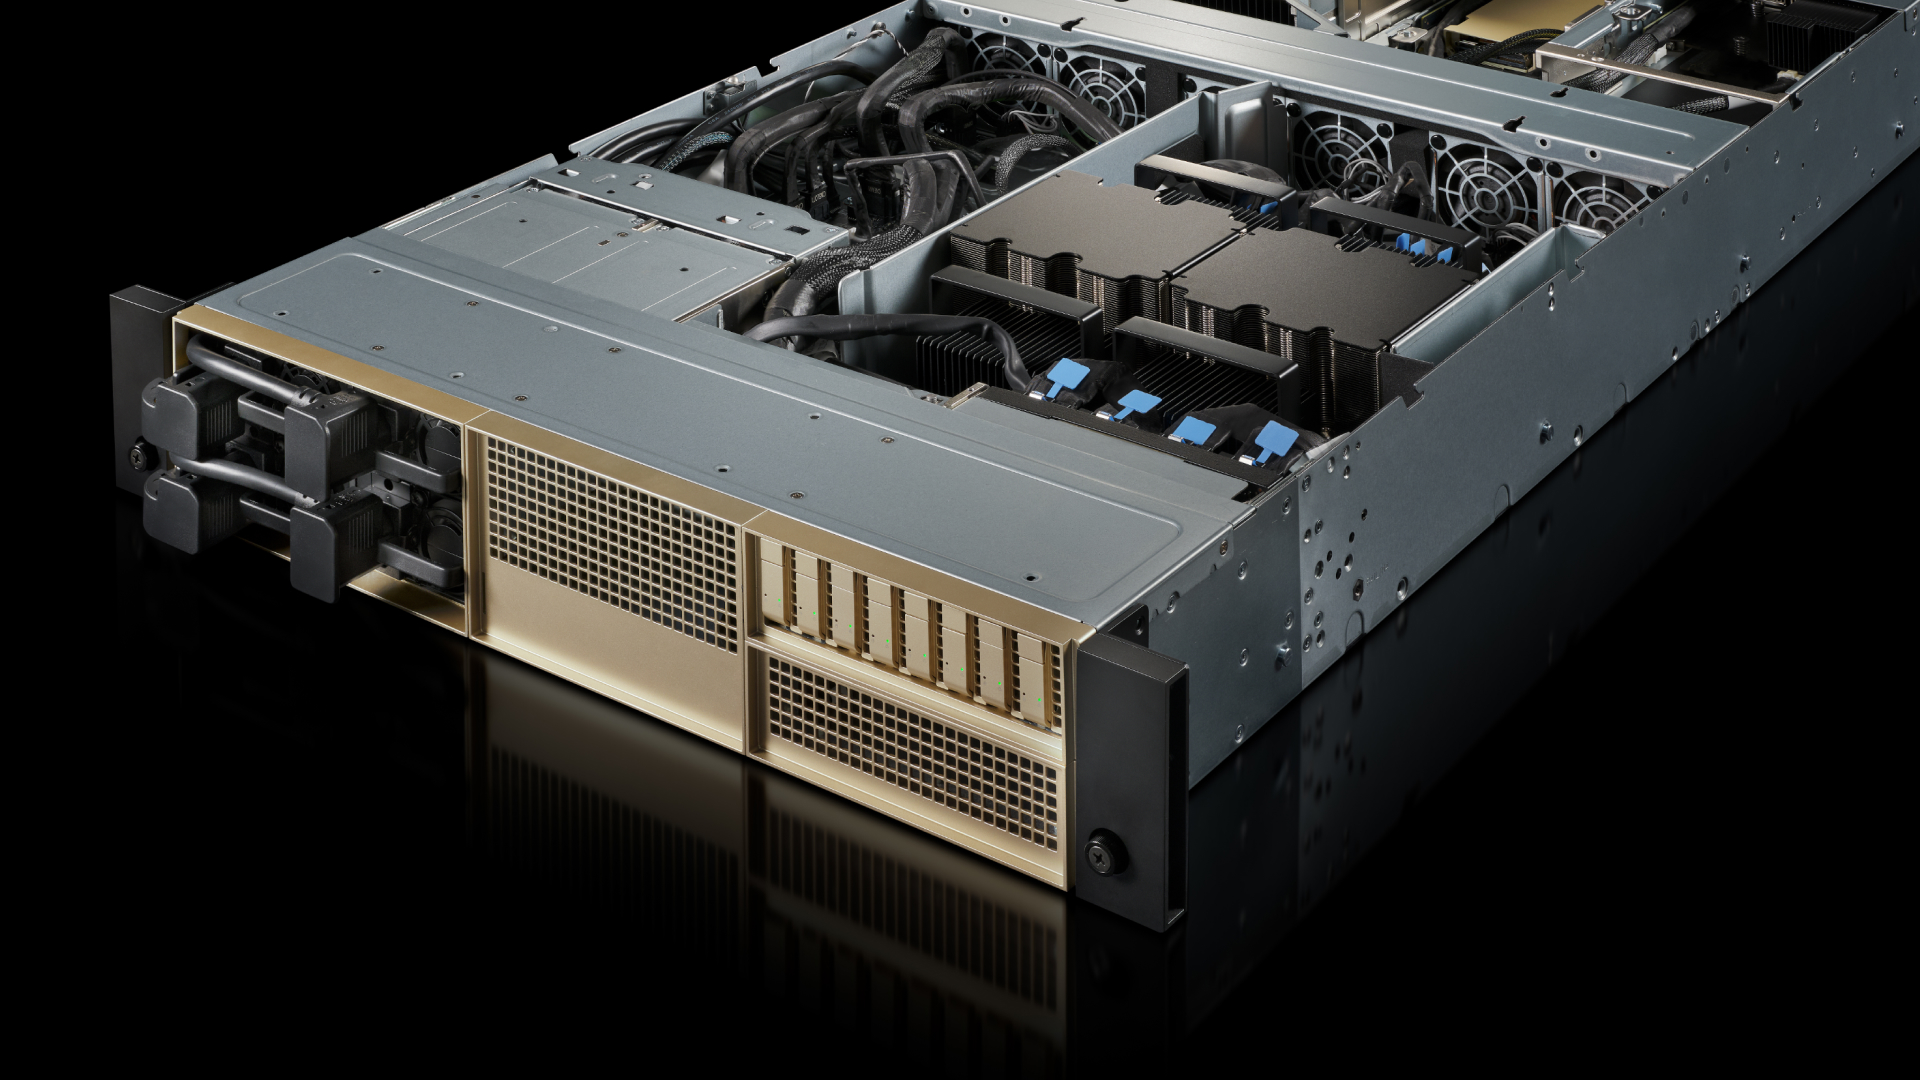
欧洲厂商转向英伟达 Vera CPU 构建本地 AI 基础设施
Nebius、Nscale 等欧洲云厂商采用英伟达 Vera CPU 搭建本地 AI 算力
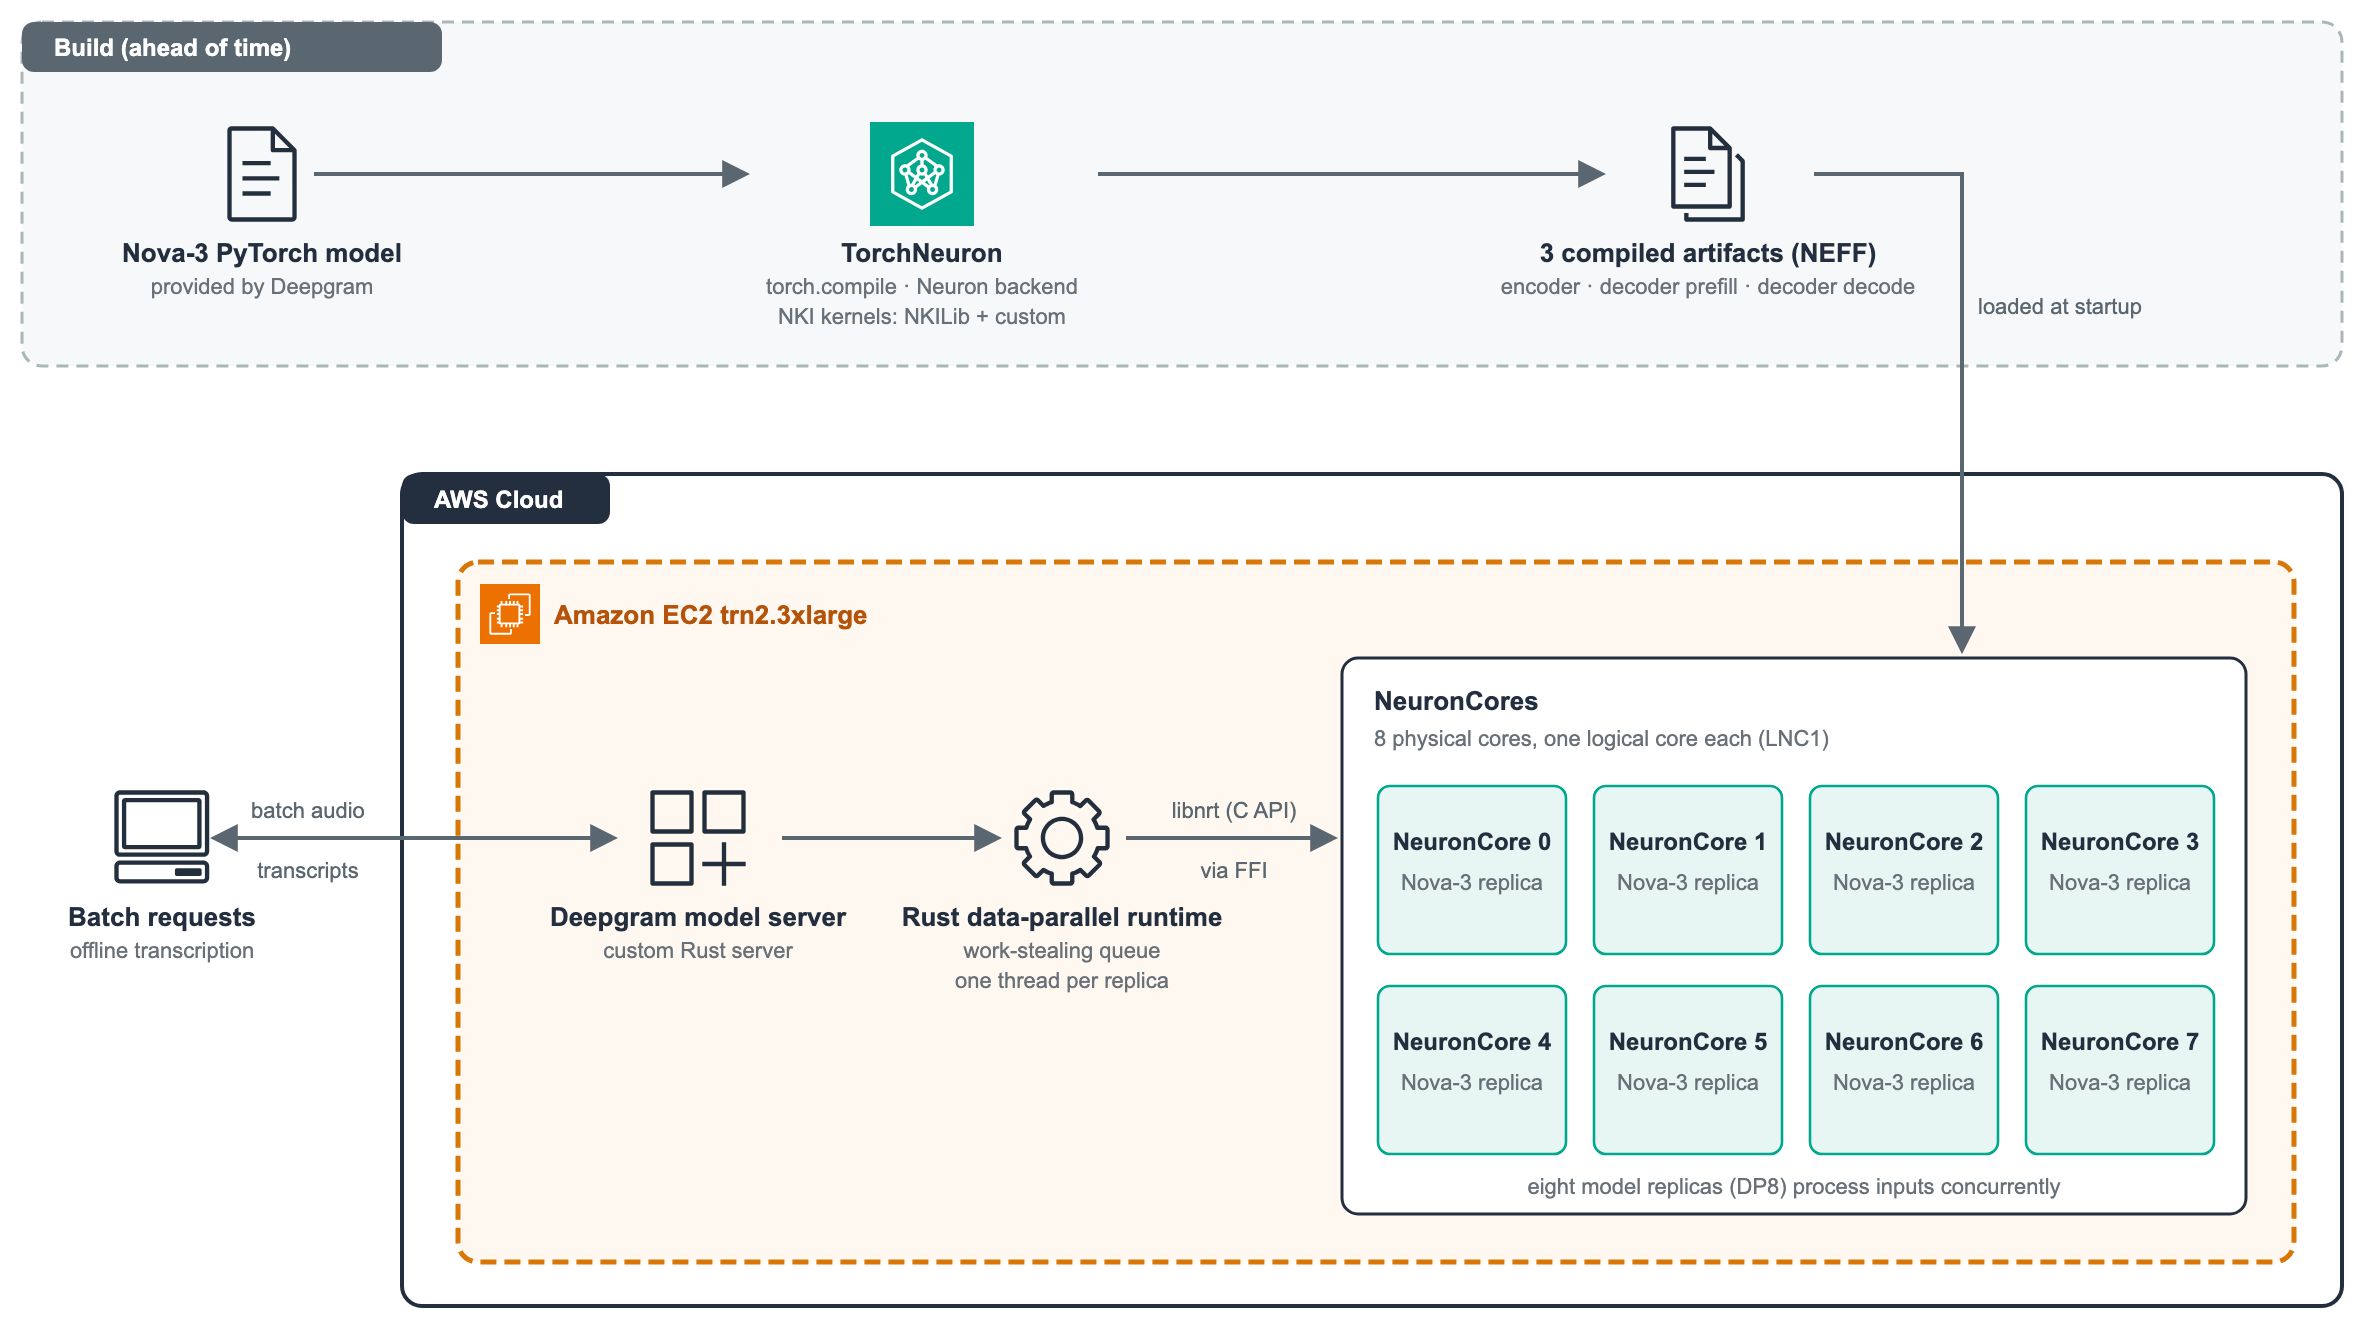
Deepgram 如何借助 AWS Trainium 大规模优化语音 AI
Deepgram 把 Nova-3 移植到 Trainium2,每美元音频吞吐提升 11%~70%
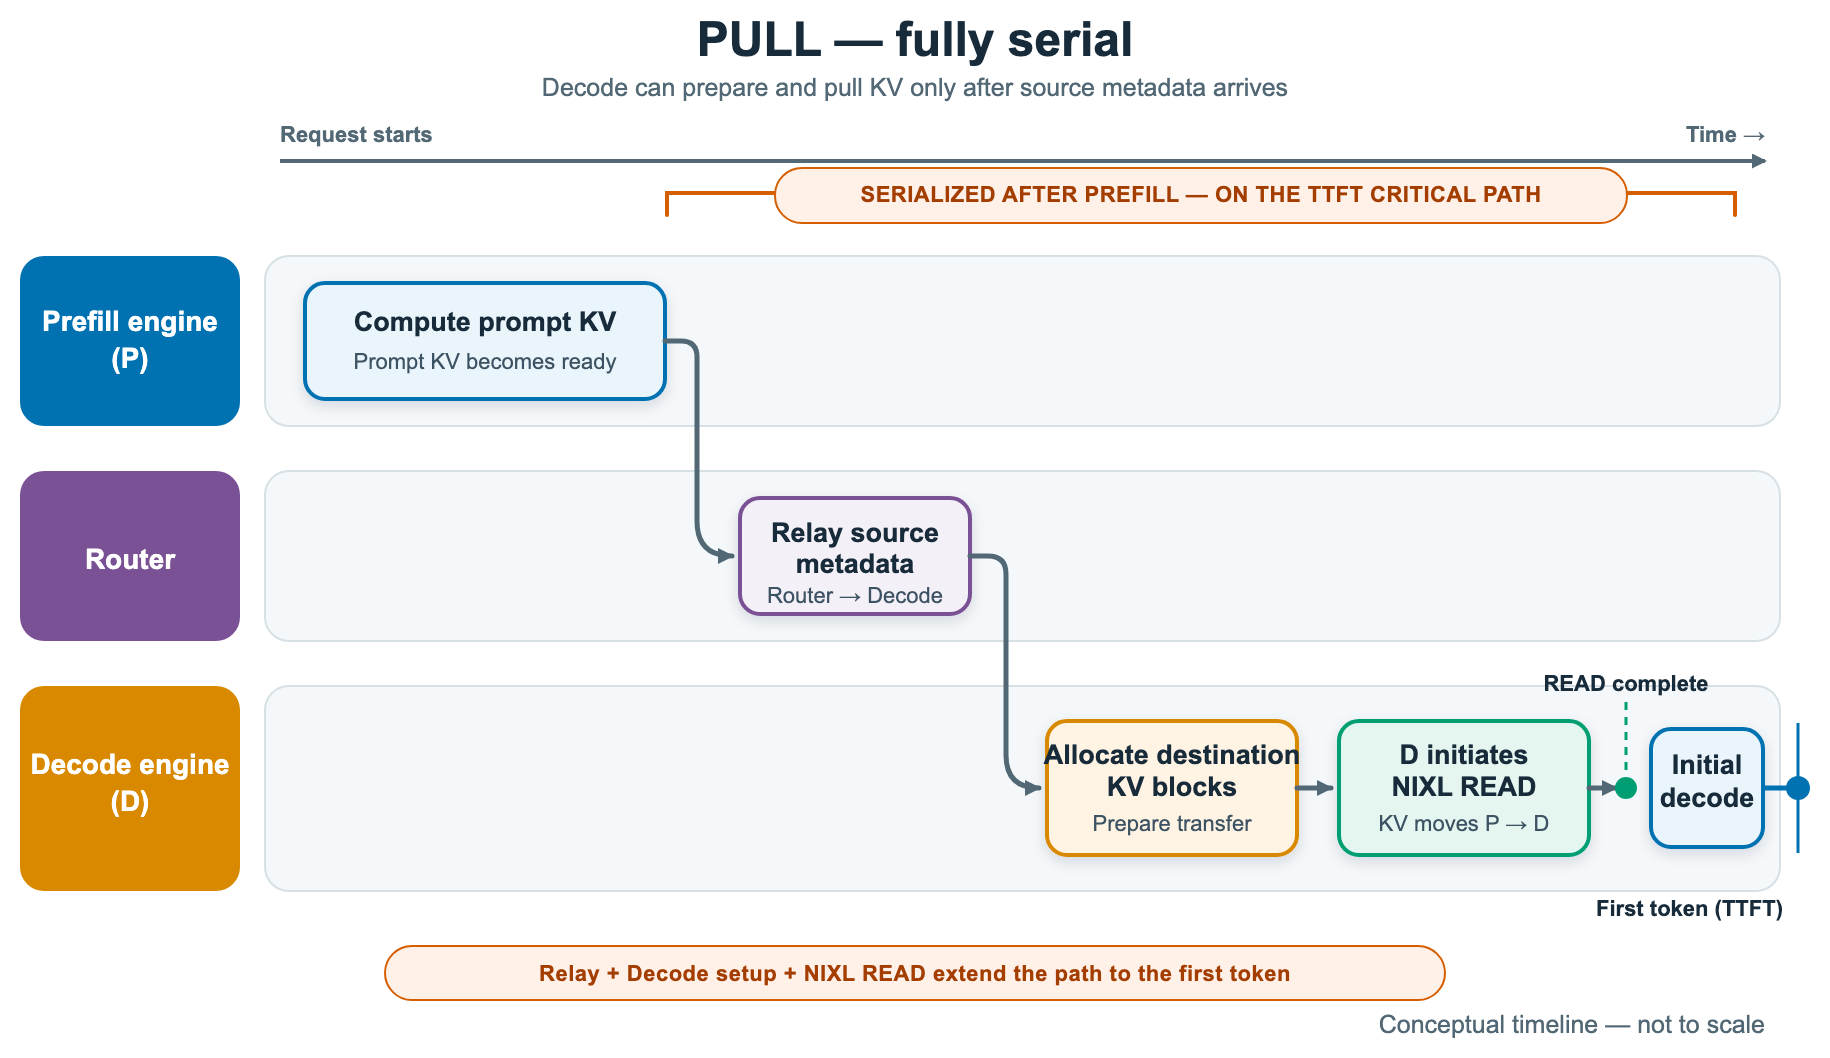
AWS 提出推送式 KV 传输:vLLM 分离式推理的 TTFT 与 TPOT 优化
AWS 为 vLLM 贡献推送式 NIXL 连接器,缩短首字延迟
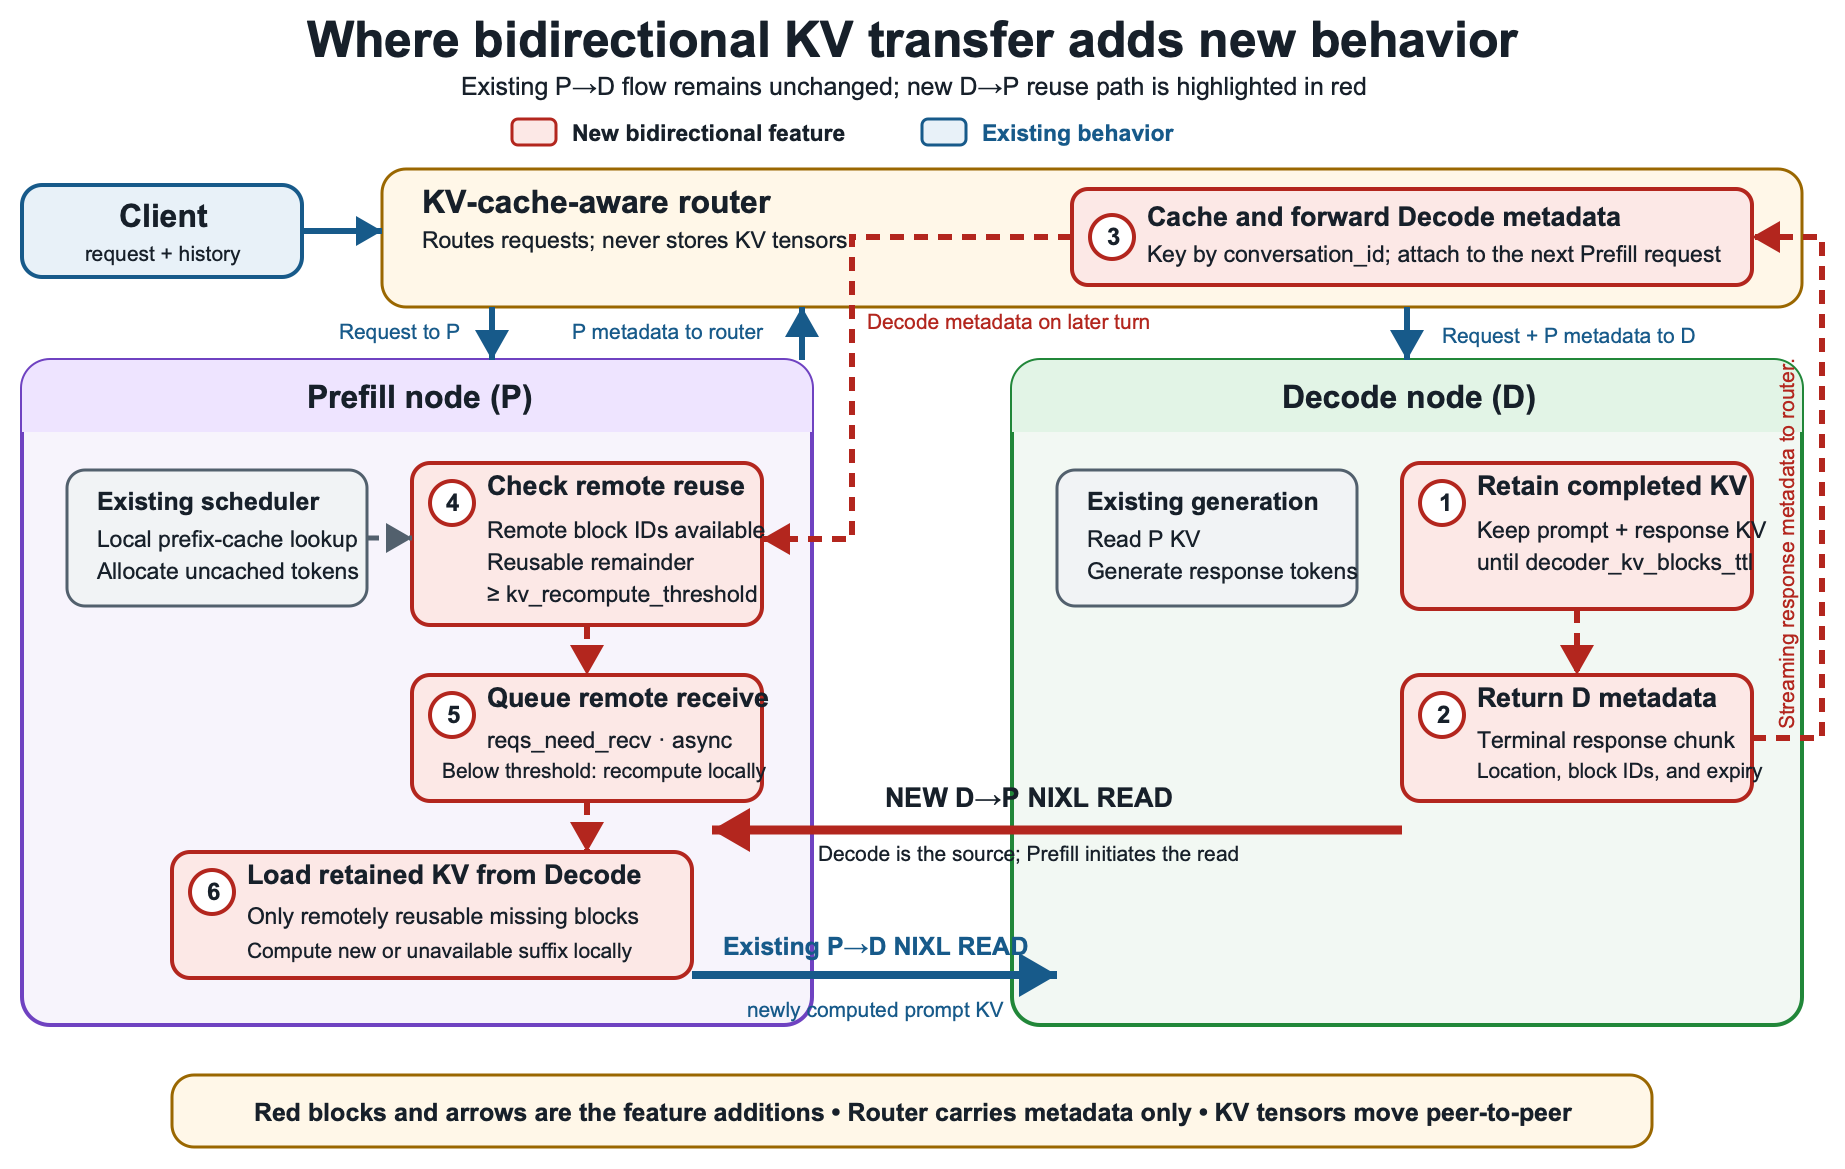
AWS 为 vLLM 贡献双向 KV 传输,多轮 Agent 场景 TTFT 最高提升 3.3 倍
通过双向 KV 缓存传输复用历史上下文,降低多轮对话首字延迟