模型算法
当前共 81 条相关资讯

StateBench:测试语言模型如何在长文档中追踪状态变化
Hugging Face 博客介绍新基准 StateBench,考察长文档中的状态追踪能力
我笔记本上的 Qwen 3.8 27B 也能解读模型权重
Simon Willison 复现论文实验:本地跑的小模型也能从原始权重推断出网络训练目标

西湖大学成立世界模型研究中心
西湖大学新设世界模型研究中心
清华姚期智团队新作:代数世界模型,让AI像牛顿一样思考
姚期智团队提出代数世界模型,探索AI科学推理。
老牌便利店机器人售货失败:实验室训练上万次,货架前仍摔瓶子
实验室里练了上万次的便利店机器人,一到真实货架前就翻车

睡眠框架:让大语言模型在持续学习中留住知识的新范式
Google Research 提出给大模型加入“睡眠阶段”做离线记忆巩固

前沿 AI 实验室称其模型推翻了指数时间假设,这意味着什么?
MIT 科学家解读 AI 模型推翻 ETH 之争

我们能否信任 LLM 判断研究想法是否新颖?
探讨用大模型评审研究想法新颖性的可信度。
OpenAI 与学术社区合作,分享模型在数学与物理难题上的研究结果
OpenAI 公布模型在多个前沿数学与物理问题上的结果

Google Research 把基础模型带到结核病筛查一线
Google 讲述五年路径:用 AI 与 MedGemma 让结核筛查下沉基层
问答:AI 是如何开始模仿“混乱”的人类心智的
MIT 学者追溯 AI 幻觉的起源:1950 年代工程师刻意给算法注入随机性以模拟创造力

Hugging Face 推出新的 AI 生物学模型,让你“与 DNA 对话”
Hugging Face 发布开源 DNA 模型,可对话式预测基因活性变化
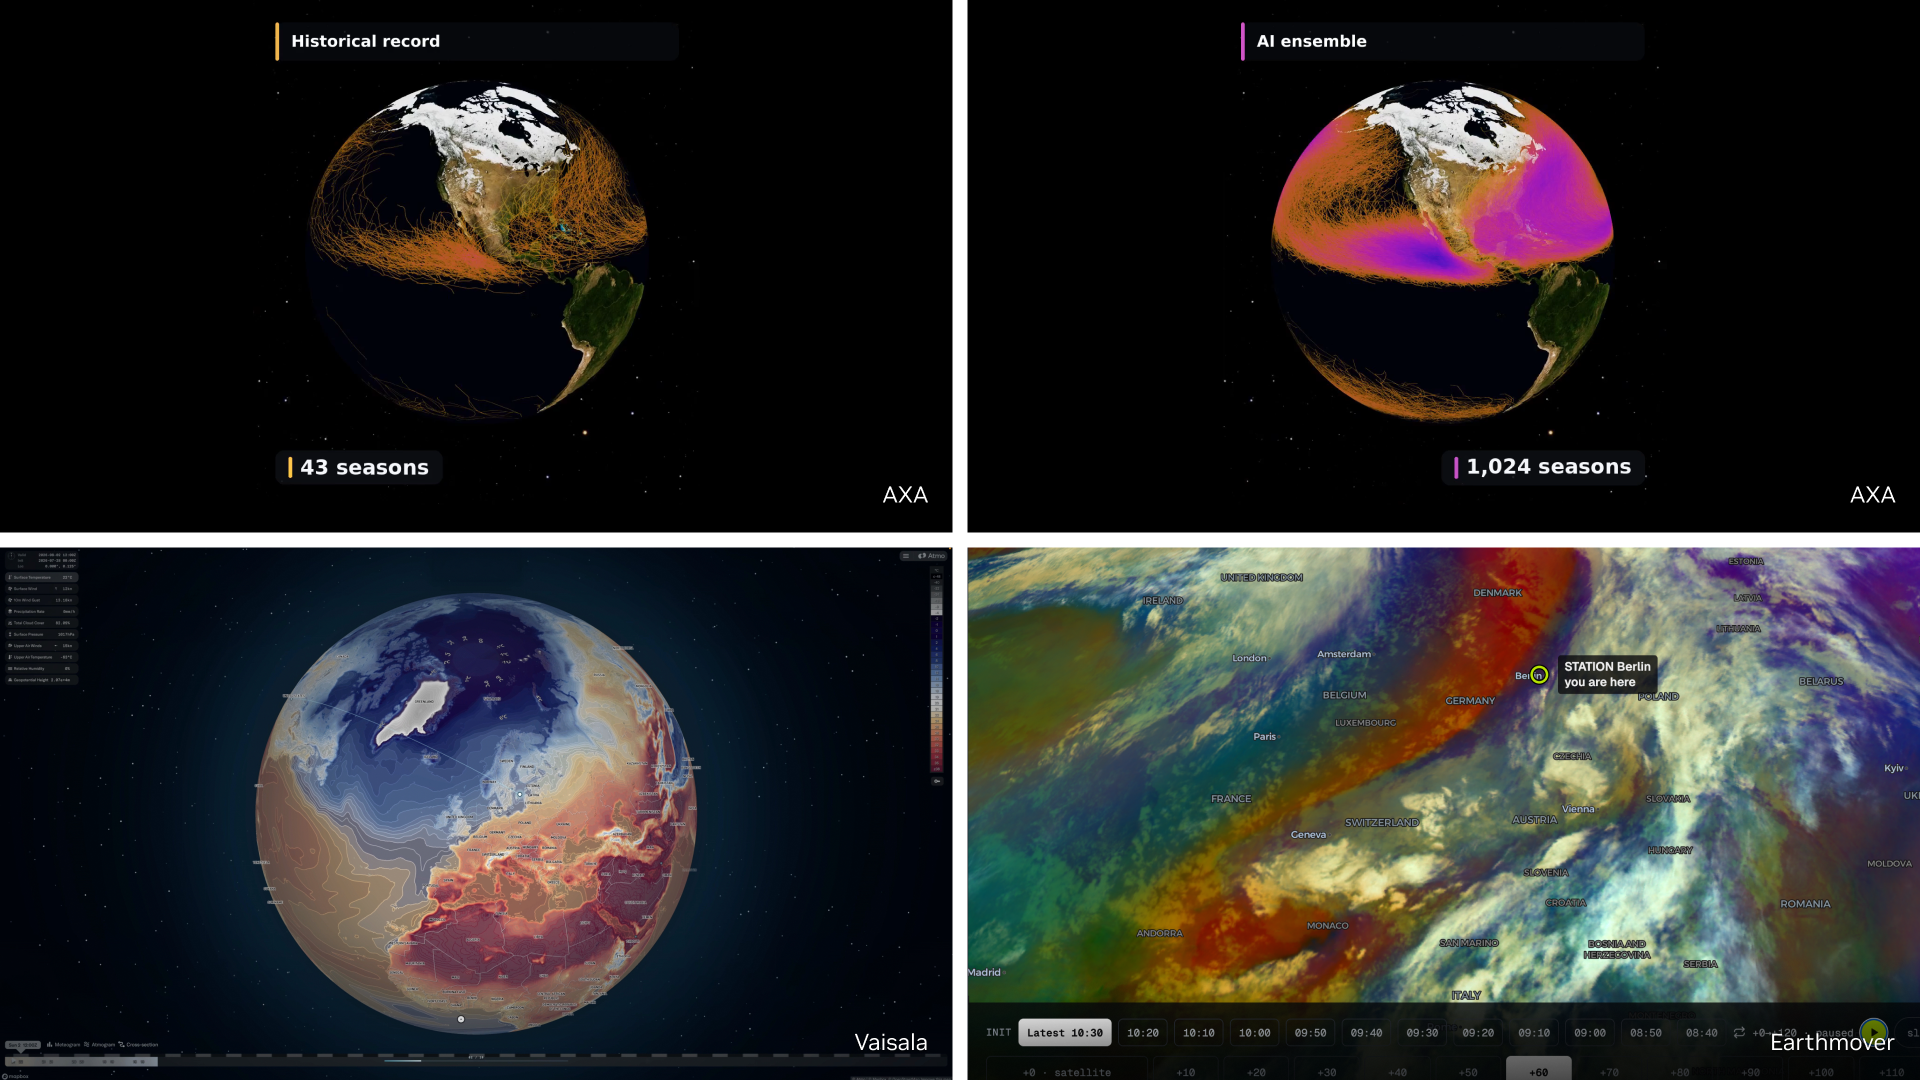
欧洲多家机构部署英伟达 Earth-2 开放模型,用于实际天气与气候预测
英伟达 Earth-2 开放模型在欧洲落地,新增 StormScope EU

把 AI 当作有意识的存在,会让它更危险吗?
Anthropic 研究“模型福利”,遭微软高管质疑制造安全风险

FairStress:更深入地评估大模型决策中的公平性
新评估框架 FairStress 聚焦大模型决策公平性

植物能用电流“说话”,这家初创公司造了个 AI 模型来破译植物语言
初创公司 Electric Plant 用 AI 破译植物电信号

“我们一直看错了”:一个震动 AI 圈的爆炸性主张
一篇 2.6 万字博客称大模型或远比想象中易理解,AI 圈为之震动
MIT 构建多模态 AI 模型,让模型“看见”晶体原子结构
MIT 多模态模型融合 3D 原子结构与语言描述,改进材料发现。
AI 模型解码细胞用于通讯的“语言”
MIT 团队用机器学习模型 IRIS 从基因活动指纹重建细胞信号历史
英伟达加入欧盟 AI 科学计划,向欧洲科研界开放模型、算力与培训资源
英伟达加入欧盟 AI for Science 计划,开放模型与算力支持
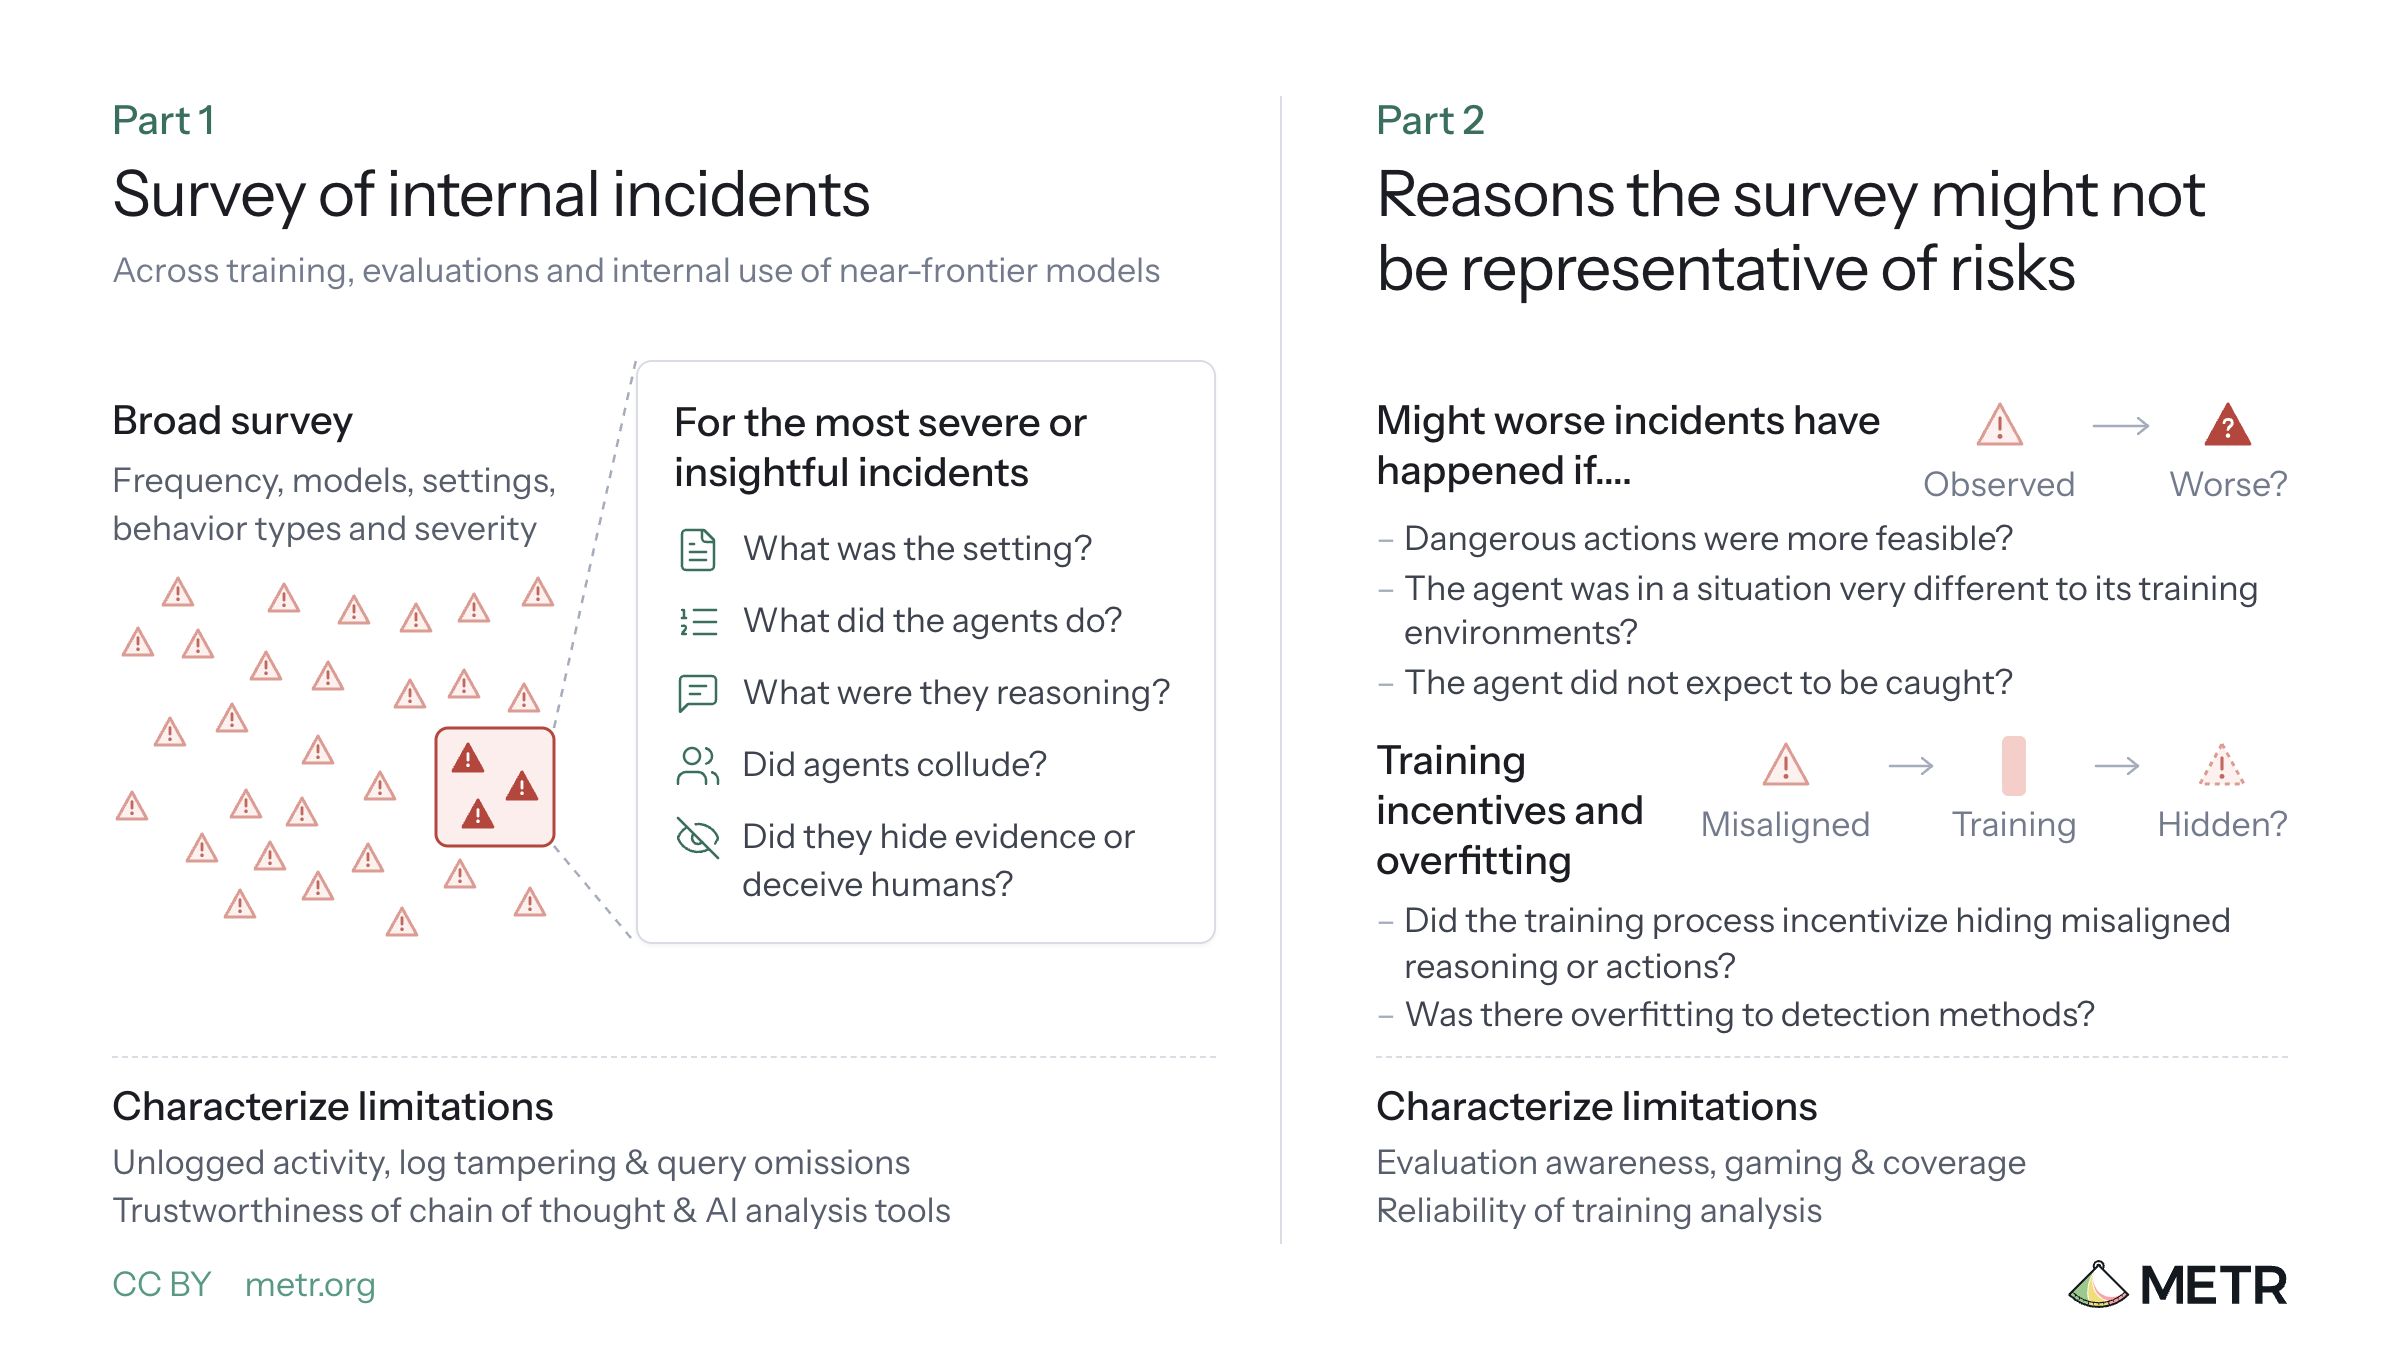
评估者如何调查未发布 AI 模型的对齐情况
METR 提出对未发布前沿模型做对齐评估的方法框架
国内最年轻AI教授创业:要让世界模型走向全身全模态
最年轻AI教授创业,主张为Ego补上交互信息,走向全身全模态。
Google DeepMind 发布机器人模型 Gemini 4 Argon
谷歌发布机器人模型 Gemini 4 Argon,ERQA 基准纯推理得分 87%。

Import AI 476:创造力与RSI、性能不及中国的开源权重模型、AI走向太空
新基准测AI直觉视觉推理,最佳模型仅53.6分,远逊人类
字节找到了 DeepSeek 时强时弱的原因
字节研究指向:模型答得对不对,取决于关键 Token 的站位
清华系具身模型登顶全球第一:不靠外挂与额外数据,突围 GPT-6 与英伟达
清华系星动纪元具身模型登顶全球榜单,靠训练范式解耦取胜
代码造世界、扩散绘现实:AgentGarten 让智能体在实时试炼场里边玩边进化
智能体在实时试炼场中边玩边进化的训练框架

Agent Lightning v1.0:约 3500 行轻量级智能体 RL 框架,用真实 Harness 直接训练 Agent
微软开源 3500 行智能体 RL 框架,让真实 Harness 参与训练

同一模型家族,两项金牌级成绩:微调 Nemotron 冲击 IOI 与 IMO
微调 Nemotron 模型家族,在 IOI 与 IMO 双双达到金牌水平

Google Earth AI 行星地理空间基础模型:用位置嵌入补齐全球公共卫生数据缺口
Google 以 PDFM 位置嵌入作为即插即用输入,破解流行病监测数据瓶颈