音视频生成
当前共 28 条相关资讯

守护知识之门:AI 垃圾内容冲击学术出版与维基百科
AI 生成内容泛滥,学术出版与维基百科如何守住可信防线
自然语言设计蛋白质与基因组:'氛围编程'进入生命科学
中团队让自然语言直接生成蛋白质设计,Hugging Face 上线 DNA 版工具。

你的机器人安全功能本身有效——可如果输入在说谎呢?
VicOne 实验室演示伪造视觉、音频和总线消息如何让机器人做出危险动作

我用AI伪造了一篇科学论文:结果如何
作者用免费AI生成假论文,测试学术出版防线。

Import AI 478:数学如何助力对齐;ProgramBench;Mirendil 揭示 RSI 意味着什么
本期 Import AI:自动形式化数学、程序生成基准与递归自我改进

微软研究院发布 Flint-interactive:让 AI 智能体生成可交互的数据可视化
微软研究院推出 Flint-interactive,让智能体生成可交互图表而非静态图。

圆桌讨论:对话 AI 设计病毒的创造者
斯坦福学者谈用生成式 AI 设计病毒基因组
问答:在公民对话中,为我们的言辞——以及 AI 的言辞——建立问责机制
MIT 学者 Deb Roy 谈 AI 生成言论的责任归属
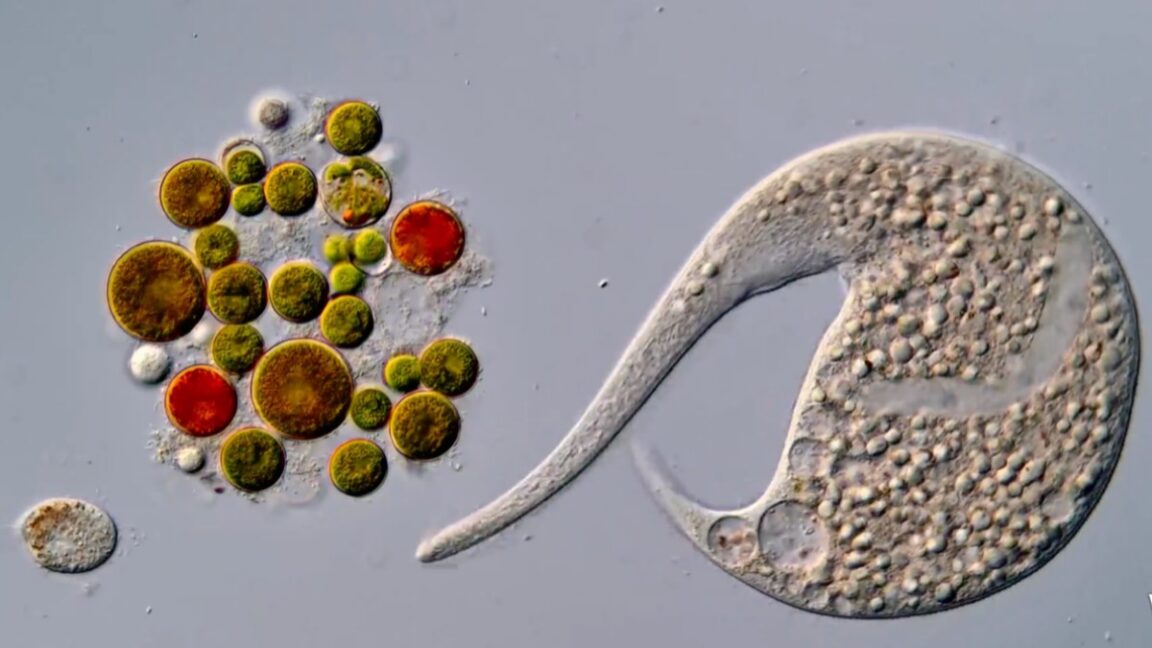
尼康显微视频大赛冠军因使用 AI 被取消资格,越南选手递补夺冠
尼康显微视频赛原冠军因 AI 违规被取消资格,越南选手递补为新冠军

代码造世界、扩散绘现实:AgentGarten 让智能体在实时试炼场里边玩边进化
智能体在实时试炼场中边玩边进化的训练框架
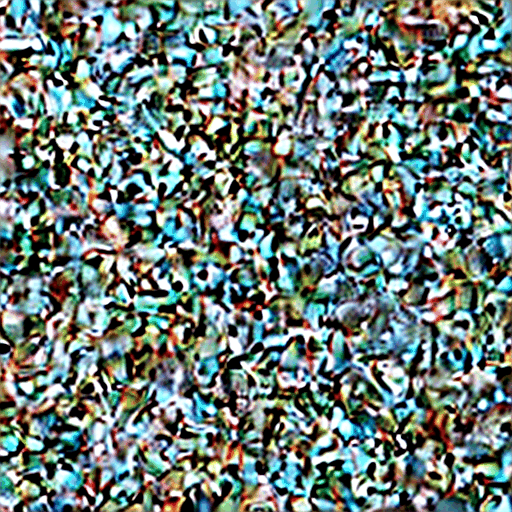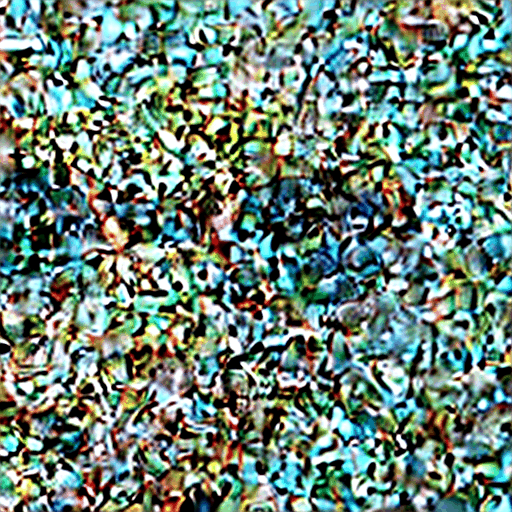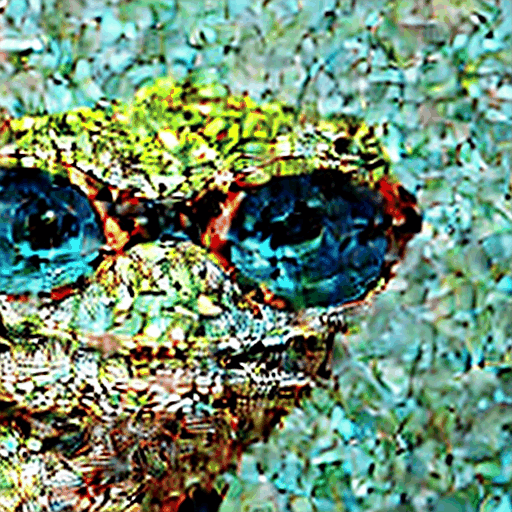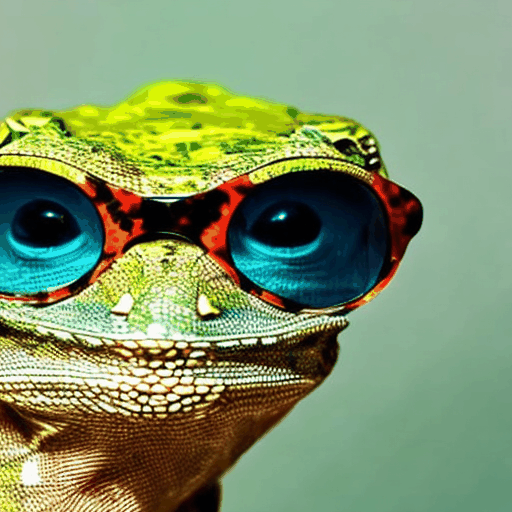
Google 发布 Diffusion Controller:统一并简化 AI 图像生成控制
谷歌提出轻量「转向阻尼」网络,精准引导图像生成

生成式 AI 让航天器获得工程师曾忌惮的自主能力
NASA 正试验用生成式 AI 让航天器自主感知、规划与决策

Google Research 推出自动化连贯长视频生成的多智能体框架
谷歌提出多智能体框架,让 AI 自动生成分钟级连贯长视频叙事

推进AMIE迈向专家级音视频临床咨询
谷歌将医学AI AMIE升级至实时视频咨询,首次展现专家级水平。
AMIE:谷歌研究医疗AI系统在首创性研究中展示实时临床视频咨询能力
谷歌AMIE医疗AI首次展示实时视频问诊,临床评估表现良好

AI智能体正击穿生物安全防线!智源、北大实测11款商用大模型,均能生成绕过筛查的拆分方案
智源与北大实测11款商用大模型,发现AI智能体均能生成绕过生物安全筛查的拆分方案。
世界模型有触觉了!50万小时视频,训出首个隐式触觉世界动作模型
首个隐式触觉世界动作模型,用50万小时视频训练而成
这,可能是今年WAIC最惊艳的图片!
WAIC上展示原生统一理解、生成、行动的AI模型。
TimeLens2:基于多模态大语言模型的通用视频时间定位
提出通用视频时间定位方法,通过区间集监督和Wasserstein奖励提升性能。
Apple-π:面向法律约束物理智能的视频推理基准测试
首个以物理定律锚定视频模型评估的基准,揭示当前模型远非可靠的世界模拟器。
S1-Omni:面向科学理解、预测与生成的统一多模态推理模型
S1-Omni统一多模态科学推理模型,在60多项基准上超越GPT-5.5和Gemini-3.1-Pro。
音视频火烈鸟:面向长复杂视频的开放音视频智能
提出开放音视频大模型AV-Flamingo,在长视频理解上超越同类开源模型。
一种将2D设计转化为3D模型以加速原型制作的更好方法
MIT研究人员开发自动化框架,提升AI生成CAD程序的准确性和效率。
VIABench:面向视障人士辅助的视频基准测试集
首个由盲人第一视角视频构建的MLLM评估基准。
分层去噪实现多步视觉推理
提出HDR框架,通过分层潜变量实现因果视频生成中的多步推理。

AI 将 DNA 折叠成微型杰作
韩国科学家用生成式 AI 简化 DNA 折纸设计,可快速生成任意形状。
Hugging Face 博客发布 Real World VoiceEQ:衡量语音 AI 的人类质量
Hugging Face 推出新指标,评估语音 AI 的自然度与人类相似度。
Chat2Scenic:基于迭代RAG的自动驾驶场景生成框架
提出迭代RAG框架,从法规描述自动生成可执行场景脚本。