AI 研究研究领域
多模态
当前共 13 条相关资讯

你的机器人安全功能本身有效——可如果输入在说谎呢?
VicOne 实验室演示伪造视觉、音频和总线消息如何让机器人做出危险动作
MIT 构建多模态 AI 模型,让模型“看见”晶体原子结构
MIT 多模态模型融合 3D 原子结构与语言描述,改进材料发现。

Import AI 476:创造力与RSI、性能不及中国的开源权重模型、AI走向太空
新基准测AI直觉视觉推理,最佳模型仅53.6分,远逊人类
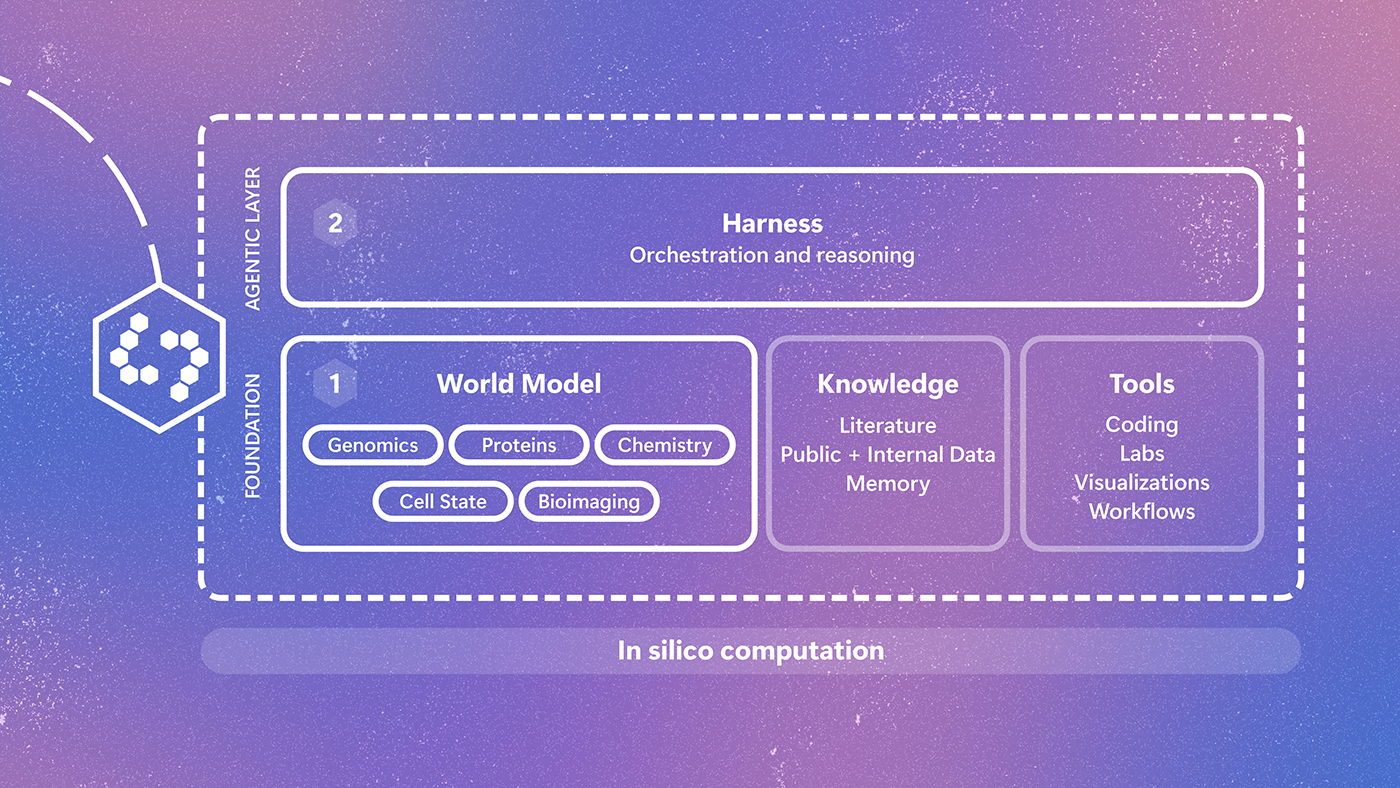
微软发布 Quine:面向生物学复杂性的 AI 研究系统
微软研究院推出生物学多模态世界模型 Quine,候选化合物经湿实验验证

MindTopo 基准揭示视觉语言模型的空间推理能力
新基准 MindTopo 评测多模态模型对拓扑关系的推理与规划能力。

推出 CARE-X:迈向临床可用的放射学视觉语言模型——辅助监督、奖励对齐学习与工具增强测量
微软发布胸部 X 光临床解读统一视觉语言模型 CARE-X

WAIC 2026|从纳米抗体到环肽:分子之心30天两度验证AI底层设计力,筑牢生物经济“多模态新基建”
分子之心30天内两次验证AI设计纳米抗体与环肽的能力
TimeLens2:基于多模态大语言模型的通用视频时间定位
提出通用视频时间定位方法,通过区间集监督和Wasserstein奖励提升性能。
S1-Omni:面向科学理解、预测与生成的统一多模态推理模型
S1-Omni统一多模态科学推理模型,在60多项基准上超越GPT-5.5和Gemini-3.1-Pro。

如何制造隐形无人机
西北大学研发 Phantom Twist 无人机,通过高速旋转实现视觉隐形。
分层去噪实现多步视觉推理
提出HDR框架,通过分层潜变量实现因果视频生成中的多步推理。

探索层次兴趣表示用于Meta广告深度漏斗优化
Meta提出层次兴趣表示(HIR),通过图学习与多模态融合优化深度漏斗广告。
RxBrain:具身认知基础模型,融合语言-视觉推理与想象
提出融合语言与视觉想象的具身认知基础模型。